前置知识与研究背景
Flux
虽然学术界依然习惯性地把 Flux、SD3 这些模型统称为“扩散模型”,但是它们的底层逻辑早就完成了换血。
从最原始的 DiT 到现在的 FLUX,主要发生了两大根本性的跃迁:
数学逻辑的跃迁
原始 DiT:基于 DDPM
我们熟悉的原始 DiT,其背后的数学框架是马尔可夫链。在 DDPM 中,把一张清晰的图片变成纯噪声,是一步一步加高斯噪声的过程。这个过程受到复杂方差表 的控制,它在数据空间中划出的是一条充满随机性的、弯曲的轨迹。因此,计算公式里必然带有 和 这样的非线性项。
FLUX:基于Rectified Flow/流匹配
FLUX 抛弃了马尔可夫链,转而采用了常微分方程 (ODE) 的视角。 Rectified Flow 的核心哲学非常暴力且优雅:既然我们要从噪声走到图像,为什么非要走弯路?直接用一条绝对笔直的直线把纯噪声分布和真实图像分布连起来就好了。
因此,FLUX 的前向过程就是极其简单的线性插值:
模型训练的目标也不再是“预测噪声”,而是直接预测这条直线上的“速度矢量 ”。
采样器工作流程:
- 起点: 采样器首先从标准高斯分布中随机抽取一个纯噪声点 ()。
- 预测速度: 将当前的噪声点和时间步 输入给 FLUX 模型,模型会预测出一个指向目标图像的“速度”或“方向”。
- 迈出一步: 采样器利用数值 ODE 求解器(如最简单的欧拉方法 Euler Method),顺着模型预测的速度方向,向前迈出一步,得到一个稍微清晰一点的潜变量 ()。
- 循环迭代: 重复上述过程,直到走完全部的时间步,最终抵达清晰的图像 ()。
采样步骤:因为 Rectified Flow 的路径被“整流”得非常直,采样器在顺着速度方向前进时不容易偏离轨道。相比于传统 DDPM 动辄需要 100 甚至 1000 步才能保证图像质量,Rectified Flow 允许采样器迈出更大的步伐(更大的 Step Size)。因此,在保证极高图像质量的前提下,可以大大提升推理速度。
架构设计的跃迁
原始 DiT:模态隔离
在原始的 DiT 中,文本和图像在模型内部是相对隔离的。Transformer Block 主要处理图像 token 的自注意力,而文本条件通常是作为额外的控制信号,通过 AdaLN(自适应层归一化)或者单独的交叉注意力注入进去。
FLUX:多模态统一
FLUX 采用了 MM-DiT(Multi-Modal DiT)架构,实现了真正的模态融合。它把文本和图像全都拉平变成一维的 token,然后直接在序列维度上拼接起来,送入统一的多模态注意力模块(MM-Attention)里混合计算。
多模态注意力机制
-
输入表示: 模型同时接收潜在图像 token 序列 和文本条件 token 序列 。
-
特征投影: 图像和文本 token 会通过各自的投影矩阵进行映射,得到对应的 Query、Key 和 Value 。具体公式如下:
-
统一计算: 接着,这些投影后的特征会在序列长度维度上拼接在一起,形成完整的 、 和 ,维度变为 。最后进行标准的注意力计算:
核心推论: 在 MM-Attention 中,图像和文本信息在注意力计算阶段就深度混合在了一起。
Double Block vs. Single Block
同时,Flux 模型里包含Double Block 和 Single Block 两种模块,如我们在 CharaConsist 里讨论的一样,并且这种架构差异对 AlignedGen 的效果产生了决定性的影响。
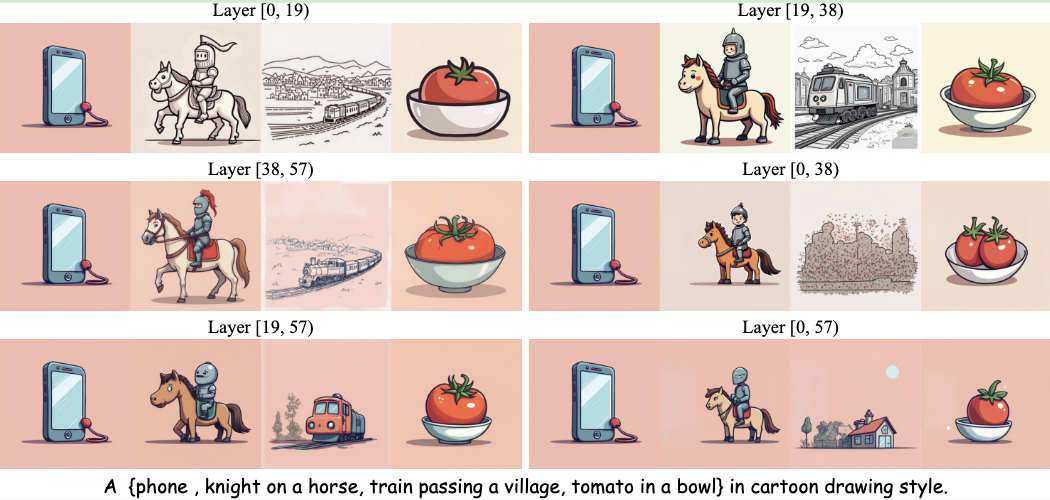
在论文的消融实验(Ablation Study)部分,作者为了寻找植入 AlignedGen 方法的最佳位置,将 Flux.1-dev 的区块划分为了三个组。
- Group 1: 前 19 个 Double Blocks(对应层数 [0, 19))。
- Group 2: 前 19 个 Single Blocks(对应层数 [19, 38))。
- Group 3: 剩余的 19 个 Single Blocks(对应层数 [38, 57))。
作者通过实验发现,扩散模型中不同的层承担着不同的功能职责 。
- 负面影响: 如果将注意力共享机制应用在 Group 1(即 Double Blocks)中,不仅没有效果,反而会破坏风格一致性。
- 正面影响: Group 2(早期的 Single Blocks)对于捕捉风格信息最为关键。
- 最终方案(层选择性应用): 为了在“文本-图像对齐”和“风格一致性”之间取得最佳平衡,AlignedGen 最终决定完全避开 Double Blocks,独占性地将方法应用在所有的 Single Blocks(即 Group 2 和 Group 3,对应层数 [19, 57))中
2D 旋转位置编码 RoPE
Transformer 架构本身是“排列不变”的,它不知道 token 在序列中的先后顺序或空间位置,因此必须显式地注入位置信息。
论文中提到 RoPE 为单张图像的 潜在网格中的每个 token 提供了唯一的空间坐标 。在处理二维图像时,2D RoPE 的核心思想是将一维的 RoPE 分别独立地应用在图像的 轴(高度)和 轴(宽度)上。
坐标注入过程
假设一个 token 的空间坐标为 ,其对应的 Query 向量为 。具体注入坐标的过程如下:
第一步:特征维度拆分
将 维的向量 平分为两半,前一半 用于编码高度信息(行坐标 ),后一半 用于编码宽度信息(列坐标 )。
第二步:定义基础旋转频率
定义频率序列,其中 :
第三步:分别应用二维旋转
对于 轴的向量 ,我们使用行坐标 作为一个标量位置,对向量中相邻的特征对 进行二维旋转矩阵相乘:
同理,对于 轴的向量 ,我们使用列坐标 施加旋转:
最后,将经过坐标 旋转的 和经过坐标 旋转的 重新拼接起来,就得到了注入了二维空间坐标 信息的完整 Query 向量。
计算过程
- 从 1D RoPE 推导内积的相对性
为了清晰起见,我们先用 1D 序列(一维位置 和 )来推导,随后再扩展到 2D。
在注意力机制中,核心操作是计算 Query 和 Key 的点积(内积)以获得注意力分数:。
假设我们在位置 有一个 Query 向量 ,在位置 有一个 Key 向量 。注入 RoPE 本质上是对向量乘以一个正交的旋转矩阵 (这里的旋转角度由位置 和预设的频率 决定)。
注入 RoPE 后的注意力分数计算如下:
根据矩阵转置的性质 ,上式展开为:
因为 是正交旋转矩阵,它的转置等于它的逆向旋转(即向反方向转),所以 相当于先往回转 的角度,再往前转 的角度。在数学上,这完美等价于一个仅与相对距离 相关的旋转矩阵 :
推论: 经过 RoPE 处理后,Query 和 Key 之间的注意力分数,仅仅取决于它们各自的内容( 和 )以及它们之间的相对位置差 ,而与它们所在的绝对位置无关。
- 扩展到 2D RoPE 的计算过程
在图像生成中,位置变成了二维坐标。假设 Query 的坐标是 ,Key 的坐标是 。
正如我们前面提到的,2D RoPE 是将向量对半拆分,一半处理行坐标(Y轴),一半处理列坐标(X轴)。点积也自然地分成了两部分之和:
这里, 是由行坐标差值 决定的旋转矩阵,而 是由列坐标差值 决定的旋转矩阵。
2D RoPE 的意义: 模型在计算图像中任意两个 patch 的注意力时,会天然地感知到它们在垂直方向差了多少行(),在水平方向差了多少列()。如果 且 (即在同一个位置),旋转矩阵就会变成单位矩阵,此时注意力分数完全由内容相似度主导,并且往往会获得极大的权重加成。
StyleAligned
StyleAligned 是这篇论文直接对标的重要前置工作。
StyleAligned 是一种免训练的图像生成方法,最初是为基于 U-Net 架构的扩散模型(如 SDXL)设计的,目的是在给定相同风格提示词的情况下,保持生成图像序列之间的风格一致性。
它的核心原理可以概括为:在自注意力层中进行“注意力共享(Attention Sharing)。
参考与目标特征的定义
在生成过程中,StyleAligned 采用了“参考-目标(reference-target)”策略。它将其中一张生成的图像指定为“风格参考图像(Reference)”,并强制其余的“目标图像(Target)”在风格上与其对齐。
在自注意力层中,这就表现为区分两组特征:
- 参考特征: , ,
- 目标特征: , ,
核心操作:自适应实例归一化 (AdaIN)
为了让目标图像的查询(Query)和键(Key)在统计分布上贴近参考图像,StyleAligned 引入了自适应实例归一化(Adaptive Instance Normalization, AdaIN)操作 。
AdaIN 的数学定义如下,它的作用是将输入 的均值 和标准差 强行对齐到目标 的分布上 :
实例归一化(IN): 在图像特征图(Shape 通常为
[Batch, Channel, Height, Width])中,实例归一化是独立地对每一个样本(Instance)的每一个通道(Channel)进行归一化。它计算单个通道内所有空间像素的均值和方差。 在计算机视觉中,特征的“空间结构(Height, Width)”通常代表内容,而“通道的全局统计量(均值和方差)”通常代表风格(颜色、对比度、笔触纹理等)。因此,IN 常用于抹去图像的原始风格。
为什么 StyleAligned 使用 AdaIN? 因为它的核心目标是风格对齐。通过对 Query 和 Key 应用 AdaIN,它在不改变目标图像空间内容的前提下,强行将目标图像的“风格分布”拉到了参考图像所在的特征空间。
注意力共享的数学重构
在生成目标图像的自注意力计算阶段,StyleAligned 对原始的 , , 进行了深度改造,这在本文中被称为“朴素注意力共享(Naive Attention Sharing)” 。
具体步骤如下:
-
重构 Query ():通过 AdaIN 将目标 Query 的分布对齐到参考 Query,形成最终的查询矩阵 。
-
重构 Key ():首先使用 AdaIN 处理目标 Key 得到 ,然后将其与参考 Key 在序列维度上进行拼接,形成最终的键矩阵 。
为什么 还要再和 拼接? 这里有一个常见的直觉误区: 里边并没有包含参考图像的“具体内容”或“局部特征”。
- 的本质是什么? 它依然是目标图像的 Key 特征,只是它的“全局统计量(亮暗、色调)”被 AdaIN 修改得像参考图像了。如果目标图像画的是一棵树, 编码的依然是树的轮廓和位置,只是披上了一层参考图像的“滤镜”。
- 为什么要拼接 ? 在注意力机制中,目标 Query () 要去和 Key () 计算相似度,从而提取对应的 Value ()。
- 为了维持自身内容: 目标图像需要生成自己的文本描述内容(比如一棵树),所以 必须去关注 ,从而提取目标图像自己的 。
- 为了借用极致的风格细节: 仅仅靠分布对齐(AdaIN)是不够的,如果参考图像里有某种非常独特的细腻笔触、水彩的晕染边缘或者特定的几何纹理,目标图像必须能够直接去查询参考图像的具体像素位置。因此,必须把原汁原味的 (以及对应的 )拼接进去。
-
重构 Value ():直接将目标 Value 与参考 Value 在序列维度上进行拼接,形成最终的值矩阵 。
实际应用
在目标图像的实际生成过程中,原本自注意力层应该使用的 Query、Key 和 Value 会被替换为上述重构后的 , 和 。
这种机制的意义在于:目标图像在计算注意力时,不仅可以“看到”自己当前的特征,还可以直接“看到”并“借用”参考图像的 Key 和 Value。因为 Query 和 Key 的分布被 AdaIN 对齐了,目标图像的各个部分会自然而然地去关注参考图像中具有相似语义特征的区域,从而在不改变自身主体内容的前提下,将参考图像的“画风(纹理、色彩、笔触等)”搬运过来。
核心问题剖析
朴素注意力共享
我们在上一节讨论的 StyleAligned 中的注意力机制在论文中被称为“朴素注意力共享”,然而,这种设计是显式地针对 U-Net 的自注意力层(仅处理图像 token)开发的。当它被简单粗暴地移植到 DiT 架构的统一多模态注意力(MM-Attention)中时,它不仅在架构上不兼容,还会因为与 2D RoPE 产生的“位置冲突”,导致严重的伪影、文本控制力丧失以及完全的模式崩塌。
位置冲突
在前边我们推导过,2D RoPE 会根据 token 所在的二维坐标 来计算相对距离。当 AlignedGen 的作者尝试将“朴素注意力共享”直接应用到 DiT 时,他们发现了一个致命的逻辑漏洞:
- 坐标重叠: RoPE 为单张图像的潜在网格中的每个 token 提供独特的空间坐标 。但是,当我们将目标图像的特征和参考图像的特征直接拼接在一起时,朴素的共享方案无意中为两张图像中相同坐标 的 token 分配了完全相同的位置嵌入。
- 这种重合引发了严重的错误偏差。模型在计算注意力时发现两者的相对距离为零,于是强迫目标图像的 token 不成比例地去极度关注参考图像中空间位置完全相同的对应点。
- 结果:这种僵硬的空间绑定完全无视了图像本身的内容或文本提示词的引导。正如论文中图 2(c) 所示,生成的图像丧失了文本控制力,出现了严重的内容泄漏,所有的生成结果都变成了参考图像的完美复制品。论文图 4 中的定量分析也证实了这一点,RoPE 的注意力被死板地限制在了绝对相同的查询坐标点上。
核心创新机制
偏移位置编码(ShiftPE)
为了解决由坐标重合引起的冲突,作者提出了一种极其简单但极其优雅的解决方案:偏移位置编码(Shifted Position Embedding, ShiftPE)。
- 核心思想: 确保参考图像和目标图像占据完全不同且互不重叠的坐标空间 。
- 具体操作: 在数学上,ShiftPE 相当于把参考图像虚拟地放置在目标图像的“旁边” 。如果图像的宽度是 ,它直接将参考图像的横坐标索引从 重新映射为 。
- 为什么有效? 这个简单的加法操作彻底打破了空间依赖关系 。现在,目标图像 位置的 token 和参考图像原本 位置的 token,相对距离变成了 。空间坐标被解耦了,内容泄漏自然就被消除了 。
- 注意力重塑: 如图 4 所示,ShiftPE 让模型不再死盯着单一的重合坐标点,而是允许注意力广泛地分布在更广阔、语义更相关的区域上。这使得注意力机制终于被“解放”出来,去关注真正具有高度语义和风格相关性的区域,而不是被死板的空间对应关系所束缚。
为什么选择线性加法操作
如果仅仅为了“打破重合”,理论上我们有很多种操作可以选择(比如给参考图像分配完全随机的坐标、或者干脆去掉它的位置编码)。但作者最终选择最简单的线性加法(将横坐标映射为 ),是因为这个操作在数学和物理意义上都达到了极其巧妙的平衡。我们可以从以下四个维度来理解为什么它是“最优解”:
完美保持参考图像的“内部结构”
RoPE 的核心在于相对距离。如果我们随机打乱参考图像的坐标,参考图像内部各个 token 之间的相对距离就会崩坏,模型就认不出那是一张完整的图了。
使用加法偏移 ,对于参考图像内部的任意两个像素 和 来说,它们的新坐标都加上了 。当计算它们内部的相对距离时,这个 会被完美抵消掉(即 )。这意味着参考图像内部的语义和空间结构被 100% 完好无损地保留了下来。
物理意义:模拟自然的“画幅拼接”
给横坐标加上图像的宽度 ,在物理意义上等价于将参考图像虚拟地放置在目标图像的“旁边” 。这就像是在一个更宽的画布上,左边画目标图像,右边贴着参考图像。预训练的 Flux 模型在训练时经常处理各种宽高比和尺寸的图像,它对这种“并排排列”的空间关系有着天然的适应能力。
避免触发“分布外 (OOD)”的注意力异常
你可能会想,为什么不加一个极大的数字,比如 ,让它们离得越远越好?
如果这样做,目标图像和参考图像之间的相对距离会变得异常巨大。预训练的 DiT 模型在训练阶段从未见过如此巨大的相对距离,这属于严重的“分布外(Out-of-Distribution)”数据。输入这样的距离会导致 RoPE 的旋转矩阵产生不可预知的行为,使得 Attention 计算出的相似度要么趋近于 0,要么产生极其诡异的极值,最终破坏特征的提取。紧贴着加一个 ,是一个模型绝对觉得“安全且熟悉”的距离。
极致的计算效率(免训练框架的初衷)
AlignedGen 作为一个“免训练”的方法,其最大的卖点就是在不增加额外模块或微调成本的情况下,直接利用现有的千亿参数大模型。加法操作在张量运算中几乎是零成本的,它不需要引入任何复杂的映射网络,兼顾了优雅与极速。
高级注意力共享(AAS)
解决了“位置冲突”这个最底层的架构 Bug 之后,AlignedGen 框架其实就已经可以跑通了。但是,为了追求极致的生成质量,作者并没有止步于此。
AAS 是一套专门为 DiT(如 Flux)量身定制的“精加工”技巧,包含三个核心操作。
选择性注意力共享 (Selective Attention Sharing, SAS)
- 痛点: 正如我们前边讨论的,Flux 的 MM-Attention 会把文本 token 和图像 token 拼接在一起处理。如果我们像传统的注意力共享那样,把参考图像的所有 Key 和 Value 都无脑借过来,就会发生致命的提示词污染。
举个例子: 参考图像的提示词是“狗”,目标图像的提示词是“飞机”。如果把包含“狗”文本信息的 Key 也共享过去,目标图像在生成时就会精神错乱,原本该画飞机的地方可能会画出带有狗特征的奇怪物体。
-
解决方案: 非常精准的“外科手术”。作者提出,仅仅共享来源于图像 token 的 Key 和 Value 。文本 token 各用各的。
-
数学表达:
经过选择性截断后,拼接公式变成了:
这样一来,目标图像既能完美接收参考图像的“视觉风格”,又不会被参考图像的“文本语义”带偏 。
通过 Key 缩放控制风格一致性 (Key Scaling)
-
痛点: 有时候我们希望风格稍微弱一点,保留更多目标图像的自然感;有时候又希望风格极其强烈。我们需要一个“旋钮”来控制风格注入的强度。
-
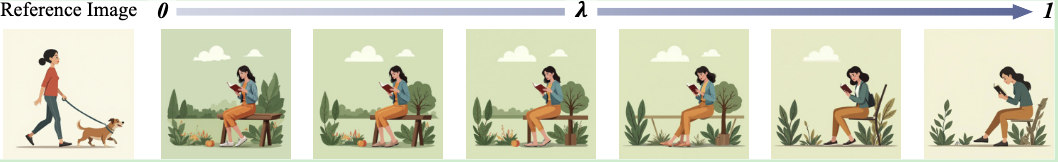
解决方案: 作者在拼接参考图像的 之前,乘上了一个标量缩放因子 。
-
数学原理: 注意力分数的计算是 。如果放大参考图像的 Key(即 ),那么在计算点积时,目标 Query 与参考 Key 的内积结果就会变大。经过 Softmax 操作后,模型就会被迫分配更多的注意力权重给参考风格。
(论文的消融实验表明,通常将 设置为 1.1 可以在文本对齐和风格一致性之间取得最佳平衡 。)
层选择性应用 (Layer-Selective Application)
- 痛点: 扩散模型中不同的网络层有着明确的分工。如果把上述的注意力共享应用到所有的网络层,生成的图像会出现严重的语义伪影和不自然。
- 解决方案: 通过大量实验,作者发现 Flux 的前 19 层(Double Blocks,组别 1)主要负责构建图像的全局几何结构和空间布局,强行在这里注入风格反而会破坏画面。而中间和靠后的层(Single Blocks,第 19 到 57 层)才是刻画颜色、纹理和风格细节的主战场。
- 实施: 因此,AlignedGen 严格限制,只在 Flux 的 [19, 57) 层替换 MM-Attention 为 ShiftPE 和 AAS 模块。
特征提取过程
AlignedGen 的生成内核我们就完全拆解完毕了!ShiftPE 解决了底层架构的 Bug,而 AAS 则把生成的上限推到了极致。
不过,这里还有一个非常现实的工程挑战:如果作为“参考图像”的那张图,不是由 Flux 自己生成的,而是用户随便上传的一张图,我们该去哪里找它的 、、 特征呢?
作者在Algorithm 1 中展现了从外部图像提取并缓存特征的过程
- 输入 : 用户提供的参考图像 ,总推理步数 。
- 输出 : 缓存的注意力特征字典
cached_qkv。
1: 初始化一个随机噪声: noise ~ N(0,1)
2: latent = vae_encode(I)
3: cached_qkv = {}
4: for t = T down to 0 do
5:     noise_input = (t/T) * noise + (1 - t/T) * latent  // 模拟加噪过程
6:     Q_t, K_t, V_t = DiT(noise_input, t, others)
7:     cached_qkv[t] = (Q_t, K_t, V_t)
8: end for
9: return cached_qkv
核心步骤详细拆解
-
步骤 1-2:降维与初始化
扩散模型并不是直接在像素空间运算的。算法首先使用 VAE (变分自编码器) 将用户提供的高清图像 压缩到潜空间,得到干净的潜在表示
latent。同时,准备一个纯随机的初始噪声noise。 -
步骤 4-5:模拟前向加噪
目标图像的生成是一个从纯噪声 () 逐步降噪到清晰图像 () 的过程。为了匹配这个过程,算法对参考图像进行了一个反向的“时间匹配”。在任意时间步 ,它将初始噪声与干净的
latent按照特定比例混合,得到一个处于中间状态的带噪潜变量noise_input。这个步骤完美模拟了参考图像在标准生成过程中经历的中间状态。 -
步骤 6-7:无梯度前向传播
这是最关键的一步。把刚刚模拟出来的带噪潜变量
noise_input,连同时间步 和文本提示词等条件,送入 DiT 模型(如 Flux)。这里不需要进行任何反向传播或模型训练。我们只让模型做一次前向推理,当数据流经我们之前确定的那几个关键层(例如前文提到的 Single Blocks [19, 57) 层)时,我们直接把模型计算出的 截取下来,并存入字典cached_qkv中。
通过这个算法,它把参考图像从极其模糊 () 到逐渐清晰 () 的每一步的风格特征 () 都记录在了字典里。等目标图像真正开始一轮一轮降噪生成时,只需要去字典里查表:“我现在降噪到第 步了,请把字典里第 步的参考特征给我拼接一下。”
这种做法完美地绕过了微调网络的巨大计算开销,真正做到了“即插即用”。
实验设计与结果分析
实验设置
为了证明方法的泛化性和实用性,作者的实验设置非常标准化,这对于复现工作非常友好:
- 基座模型: 作者选用了开源的 Flux.1-dev 作为核心骨干模型。结合我们前面学到的高级注意力共享(AAS),作者仅仅在模型的 Single Blocks(即第 层)中,将原始的 MM-Attention 替换为了他们设计的 ShiftPE 和 AAS 模块。
- 采样参数: 推理时,使用的是 Rectified Flow 采样器,采样步数(sampling steps)设为 30,无分类器引导比例(CFG scale)设为 3.5 。
- 思考: 这里的参数非常常规,没有为了刷榜而使用极端的采样步数。这意味着该方法具有真正的即插即用特性,计算开销极小,这对于算力资源受限的研究场景来说是个巨大的利好。
- 评测数据集: 为了公平对比,作者直接复用了前置工作 StyleAligned 提供的 100 组提示词集(prompt sets)进行测试。
评价指标体系
做风格迁移或一致性生成,最难的就是“定量评估”,因为风格是一个相对主观的概念。作者使用了三个非常严谨的客观指标来构建评价体系:
文本对齐度 ()
- 测什么: 生成的图像到底有没有听提示词的话?(比如提示词是飞机,有没有画成狗)。
- 怎么测: 计算生成图像与输入提示词之间的 CLIP 余弦相似度。分数越高,说明图像内容越契合文本描述。
基于 CLIP 的风格一致性 ()
- 测什么: 同一组生成的几张图片,看起来是不是同一个画风?
- 怎么测: 提取生成的这一组图像的 CLIP 视觉特征向量,然后计算它们两两之间的平均余弦相似度
基于 DINO 的风格一致性 ()
- 测什么: 纯粹的视觉风格(笔触、纹理、色彩等),剥离语义内容的干扰。
- 怎么测: 计算这一组图像的 DINO 特征向量的两两平均余弦相似度。
- 为什么要引入 DINO:作者指出,CLIP 是用“图像-文本对”进行监督训练的,它对物体的语义类别非常敏感。如果两张图都画了一只猫(即使一张是水彩,一张是 3D),CLIP 也可能因为“猫”这个语义标签而给出很高的相似度,这会成为风格评估的“作弊器” 。而 DINO 是通过自监督学习训练的,它不依赖类别标签,因此能更加敏锐、纯粹地捕捉到图像的底层视觉特征(如真实的绘画风格差异)。
DINO: DINO (DIstillation with NO labels) 是由 Meta AI 提出的一种针对视觉 Transformer (ViT) 的自监督学习 (Self-Supervised Learning) 方法。 DINO 完全不需要任何人工标注的标签(No labels)。它通过一种巧妙的“自我博弈”来学习图像的深层特征:
- 图像裁剪: 取同一张图像,对其进行不同的数据增强,裁剪出“全局视角(大图)”和“局部视角(小图)”。
- 双网络架构: 构建两个结构相同的网络——学生网络 (Student) 和老师网络 (Teacher)。
- 特征匹配: 将不同的裁剪图像分别输入给这两个网络。模型强制要求学生网络去预测老师网络的输出分布。由于它们看的是同一张图的不同部分,模型被迫去理解图像内部深层次的纹理、结构和物体边界,而不是简单地记住某个类别。
- 动量更新: 老师网络并不参与反向传播,它的权重是学生网络权重的指数移动平均 (EMA),这保证了训练的稳定性。
对比实验
为了证明 AlignedGen 的强大,作者挑选了目前市面上最具代表性的 5 个 Baseline 进行了全方位的对比 :
- 经典免训练法: StyleAligned (本文的直接优化对象) 。
- 主流 Adapter: IP-Adapter (专为 Flux 适配的版本) 。
- 单图微调法: B-LoRA (基于 LoRA 的微调) 。
- 大规模数据集驱动法: StyleShot 和 CSGO 。
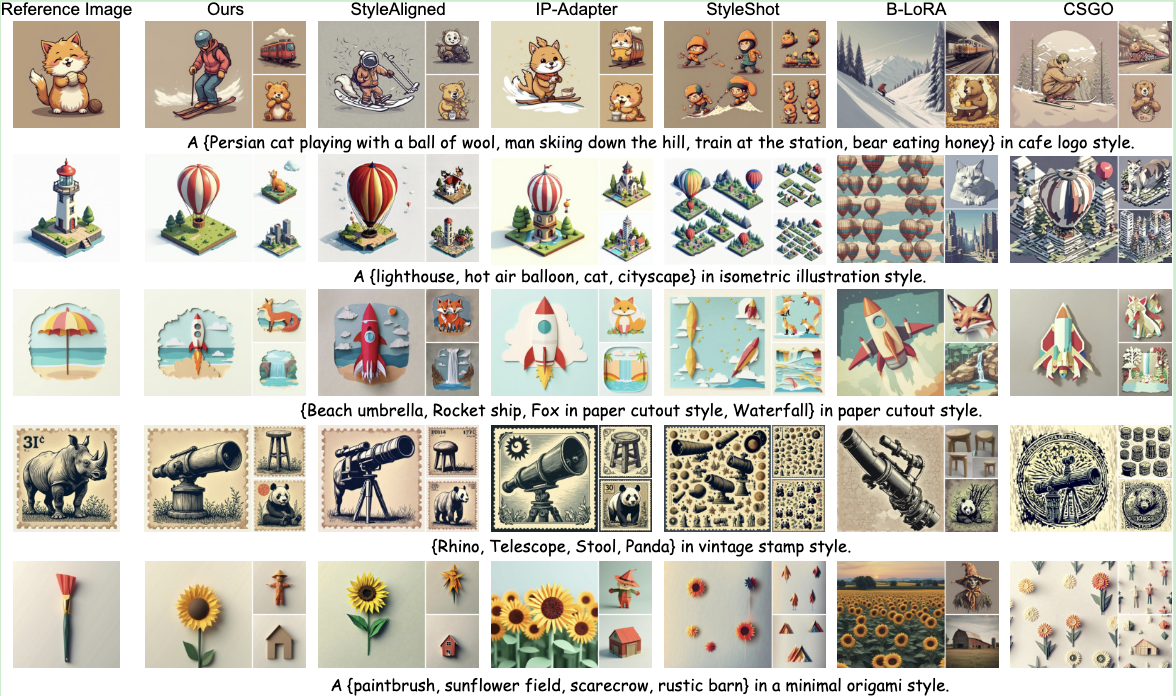
定性分析 (Figure 8):
- IP-Adapter: 难以有效捕捉风格,不仅生成的图像风格不一致,还出现了明显的内容泄漏。
- B-LoRA: 因为只用一张图训练 LoRA,训练难度极大,导致生成的图像很难抓住参考图的精髓。
- StyleAligned: 风格一致性尚可,但在大模型下生成的图像视觉质量很差,充满了伪影。
- StyleShot & CSGO: 虽然是基于大数据集训练的,但经常出现图像重复和视觉伪影的问题。
- AlignedGen (Ours): 赢得很彻底,不仅风格高度统一,而且完美契合了文本提示词的要求。
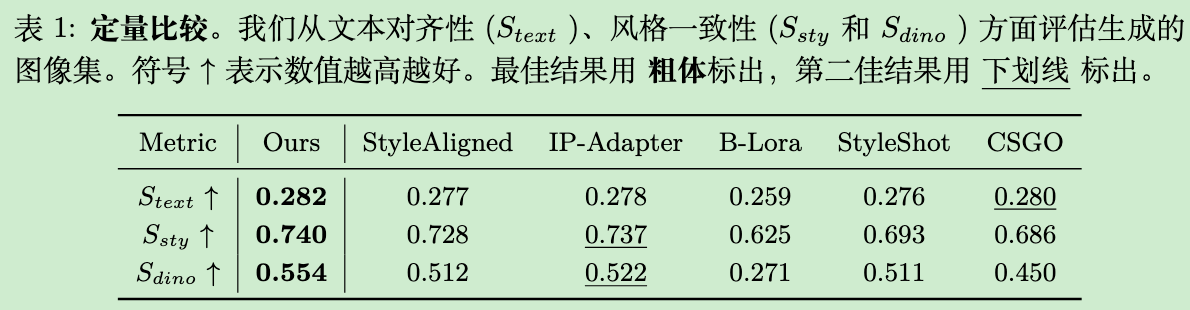
定量分析 (Table 1):
结合我们在前面讨论的三把评估指标:文本对齐度 ()、CLIP 风格 () 和 DINO 风格 ()。如表 1 所示,AlignedGen 在这三个指标上全面霸榜,拿下了最高分。这在数据层面实锤了它在“听懂提示词”和“稳住画风”之间找到了最优解。
消融实验
证明了自己比别人强之后,作者需要回答:“我的模型到底是怎么变强的?”。消融实验 (Table 2) 逐一验证了我们在第二阶段拆解过的核心模块。
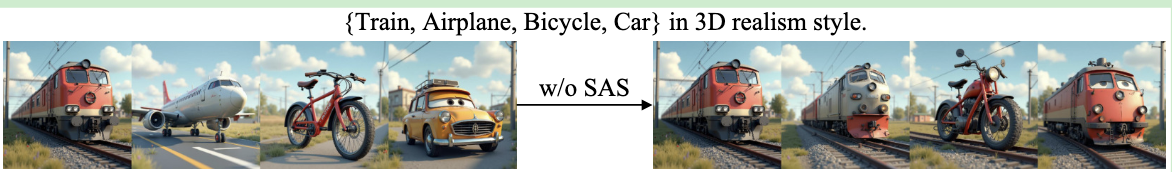
为什么要用选择性注意力共享 (SAS)?
- 做法: 对比 Table 2 中的 (k) 组 (无 SAS) 和 (l) 组 (有 SAS) 。
- 数据结果: 拿掉 SAS 后,不仅 和 掉了下来,更重要的是 也没有提升。
- 视觉直观 (Figure 9): 如图 9 所示,如果不做选择性共享,提示词污染就会发生。比如明明要求画飞机 ,模型却被参考图带偏,画出了奇怪的非飞机物体。
为什么要挑层?为什么选 [19, 57)?
作者把 Flux 的网络层分成了三组:Group 1 [0, 19) 的 Double Blocks,Group 2 [19, 38) 的 Single Blocks,和 Group 3 [38, 57) 的 Single Blocks 。
- 数据发现:
- Group 2 对于捕捉风格是最核心的 。
- 千万不能碰 Group 1!把方法用在 Group 1 (Double Blocks) 上不仅没用,反而会破坏风格一致性 。
- 最终定稿: 同时应用在 Group 2 和 Group 3 (即所有的 Single Blocks) 能在文本对齐和风格一致性上达到最佳平衡。
- 视觉直观 (Figure 6): 图 6 清晰地展示了,如果在全层应用或者错误层应用,画面结构会扭曲;只有在 [19, 57) 层应用,生成的番茄、骑士才既有原图的线条风格,又保持了正常的物理结构。
缩放因子 () 到底设多少合适?
- 核心矛盾: Table 2 显示,随着 的增大,画风会越来越像参考图 ( 升高),但代价是不太听提示词的话了 ( 下降) 。这在图 5 中也有直观体现。
- 最终定稿: 大量实验表明,将 设定为 1.1 是一个“甜点位 (Sweet Spot)”,达到了最佳的平衡。
泛化性与兼容性
作者在最后一部分向学术界展示了 AlignedGen 的工程潜力和通用性,证明了这不仅仅是一个为了发论文而强行凑出来的“特例”。
- 跨模型泛化: AlignedGen 的核心逻辑(解决 2D RoPE 的位置冲突)并非 Flux 独有。作者将这套方法直接套用到了同样基于 DiT 架构的 Stable Diffusion 3 (SD3) 和 SD3.5 上。正如论文图 10 和图 12 所示,它在这些模型上同样实现了完美的风格一致性迁移。
- 与其他工具的无缝兼容 (Compatibility with Existing Tools): 作为一个完全免训练的即插即用模块,AlignedGen 可以和现有的各种图像生成控制技术叠加使用。
- 比如结合 Dreambooth 进行主体驱动生成(图 13),不仅能保持主体一致,还能统一特定画风。
- 结合 Depth Control (深度控制)(图 14),在控制物理空间深度的同时,依然死死咬住参考图的艺术风格。
总结与研究启发
AlignedGen 最迷人的地方在于它全程没有更新大模型的任何一个参数。在计算资源极其有限的环境下,去卷庞大的数据集或者昂贵的微调是非常吃亏的。这篇论文指明了一条极其高性价比的科研路径:去深度剖析开源模型(如 Flux)底层的注意力矩阵和位置编码。
当你发现模型底层的数学逻辑(比如 RoPE 的位置重合导致内容泄漏 )存在盲区时,只需要像 ShiftPE 那样加一个简单的偏移量 ,就能撬动千亿参数大模型的惊人潜力。