领域背景与前置概念
新视角合成(NVS)任务定义
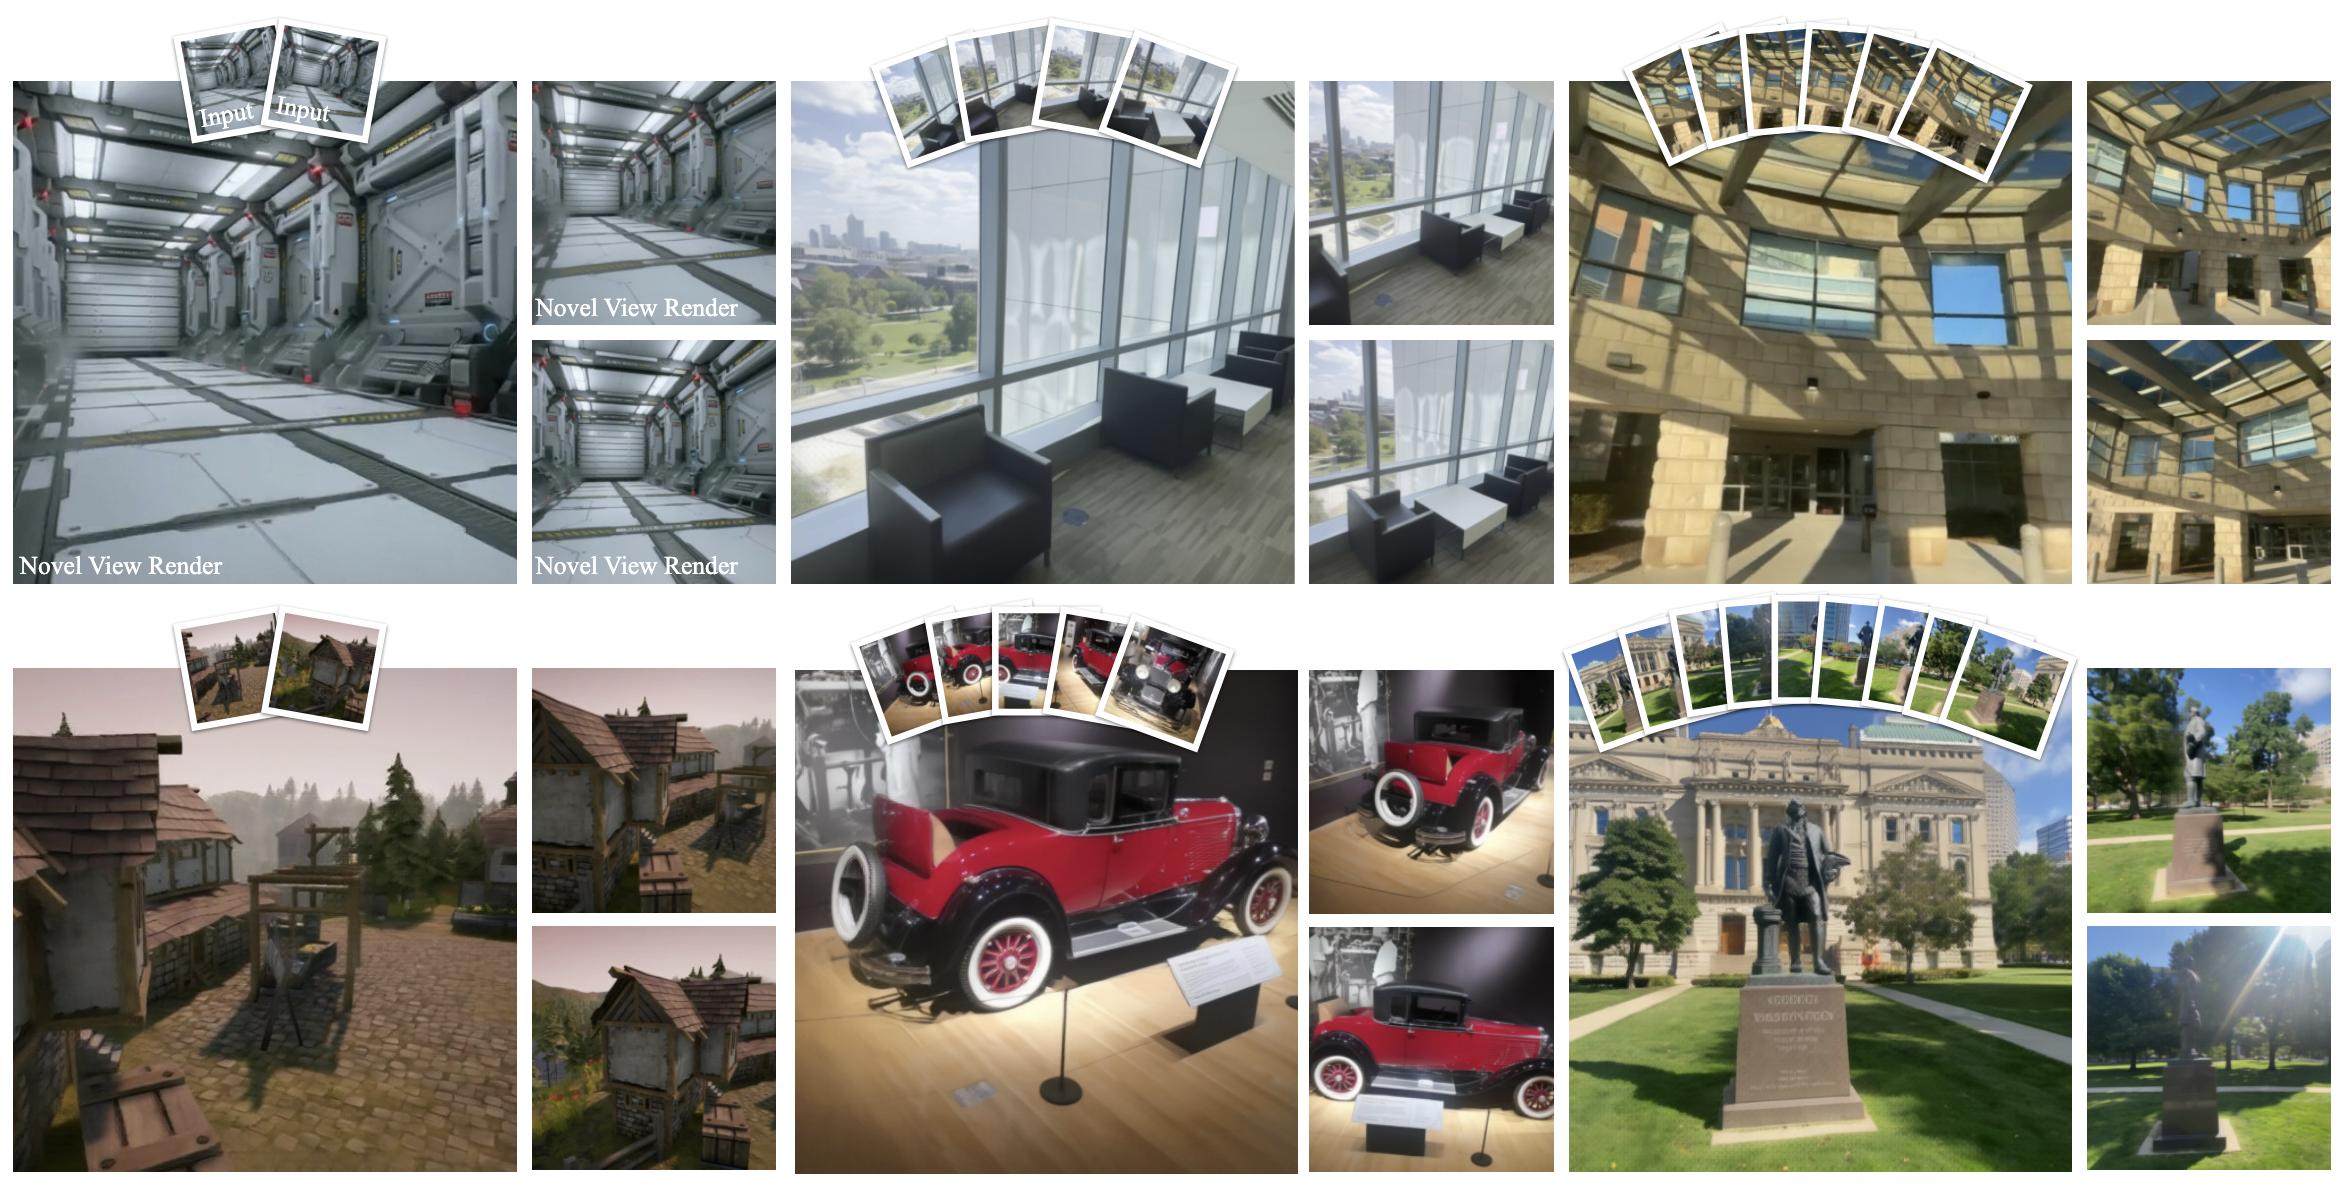
简单来说,NVS 的任务是:给定几张从特定角度拍摄的场景照片,然后用 AI 推理并生成出一张从“全新角度”拍摄的该场景照片。
在数学上,这篇论文将其定义为一个函数映射:
给定 张源图像 及其对应的源相机姿态 ,以及一个目标相机姿态 。我们需要输出一张目标视角的图像 :
两种3D 表征路线
显式 3D 表征
比如传统的 Mesh(多边形网格)、Point Cloud(点云)、或者是前几年大火的 NeRF(神经辐射场)和最近的 3 D Gaussian Splatting (3 DGS)。显式意味着,网络会在 3 D 坐标系 中结结实实地“建个模”,告诉你这个坐标点有没有东西、是什么颜色。
缺点: 计算极度耗时,且往往需要针对每一个新场景单独优化。
潜空间几何
LagerNVS 放弃了在空间中老老实实建个 3D 模型的想法。它使用一个强大的 Transformer 编码器(基于 VGGT),将输入的几张图像直接编码成一堆一维的特征向量 (Tokens) 。虽然这些 Token 在人类看来只是毫无意义的数字矩阵,但经过大规模训练后,这些特征向量内部其实包含了“3D 感知 (3D-aware)”的信息。随后,一个轻量级的 Decoder 直接利用这些特征“画”出新视角的图像。这就是为什么它的速度能达到 30 FPS+ 的实时级别。
相机模型
在深度学习做图像分类时,我们不在乎照片是在哪里拍的。但在 NVS 中,“相机在哪里”和“相机指向哪里”是决定性信息。要让网络知道这个相机的状态,需要回答三个问题:相机在哪里?相机的硬件属性是什么?这个世界的比例尺是多大?
外参
外参定义了相机在 3 D 世界坐标系中的位置和朝向。
-
平移向量 (Translation, ): 这是相机的绝对位置。它是一个 3 D 向量 ,告诉你相机镜头当前在空间的 坐标。
-
旋转 (Rotation, ): 相机放在了那个位置后,它是抬头、低头,还是向左偏?传统图形学喜欢用 的旋转矩阵,但神经网络不喜欢,因为 9 个数字有冗余且不好优化。所以这篇论文(以及大部分深度学习 3D 任务)使用了单位四元数 (Unit Quaternion) 。你暂时不需要深究四元数的计算法则,只需把它当作一个 4 维向量,它能连续、无死角地表示 3D 空间中的任意旋转角度。
内参
内参和相机摆放在哪里无关,它只取决于相机本身的硬件设计。
-
在大部分 3 D 深度学习任务中,最核心的内参就是焦距 (Focal Length) 或视场角 (Field of View, FOV)。
-
论文中用 表示水平和垂直的视场大小。如果 FOV 很大,相当于挂了一个超广角镜头(画面装得下更多东西,但边缘会变形);如果 FOV 很小,就相当于长焦镜头(画面有放大的效果)。
场景尺度
论文中特别引入了 。这是因为在纯视觉 3 D 重建中,存在一个著名的尺度模糊 (Scale Ambiguity) 问题:画面里的一辆车,是 10 米外的一辆真车,还是 10 厘米外的一辆玩具车?单凭像素是无法区分的。
当你要进行新视角合成(NVS)时,如果你告诉网络:“请把相机向右移动 1 个单位。” 网络会很懵:这 1 个单位到底是 1 米(真实场景),还是 1 厘米(微缩模型)?如果它搞错了比例尺,渲染出来的画面就会发生严重的形变。因此,网络必须知道目标相机的移动距离与当前场景的比例关系。
为了解决这个问题,最理想的情况是用绝对物理单位(比如米),但作者提到,收集海量带有绝对物理尺度的训练数据太难了。于是,作者退而求其次,设计了两种“相对比例尺”: 和 。
:基于最大平移
这是最常规、也最容易获取的一种比例尺。
-
定义: 被定义为所有源相机相较于参考相机(第一台相机)的最大平移距离。用数学公式表示就是 。
-
物理意义: 假设你围着一个雕像拍了 5 张照片,你走动最远的那段距离,就是这个场景的基准长度(设为 1 个单位)。目标相机的移动,都是相对于你这一步跨度的百分比。
-
优点: 只要有多张带姿态的照片,计算极其简单快速。
-
致命缺陷: 如果你只有单张照片(Single-view NVS),或者你拿着相机站在原地仅仅是转了转头(相机光心重叠),你的移动距离就是 0,此时 。比例尺失效,网络直接崩溃。
:基于平均深度点
为了弥补 在单图或原地旋转时的缺陷,作者引入了 。
-
定义: 被定义为从参考相机出发,到所有可见 3 D 空间点的平均距离。
-
物理意义: 既然相机没动,那我就看看眼前的风景。如果我看到的大部分物体离我平均有 5 米远,那我就把这 5 米当作场景的基准长度(设为 1 个单位)。
-
优点: 完美拯救了单视角输入的情况。只要画面里有东西(有深度),就能算出一个比例尺。这正是 LagerNVS 能够支持单图 NVS 平移渲染的核心秘密。
普吕克坐标系与射线
当 Decoder 要渲染目标视角的图像时,它怎么知道屏幕上的每个像素对应真实世界里的什么东西? 这就涉及到光线投射 (Ray Casting)。相机的每一个像素,其实都可以看作是从相机中心射出的一条射线。
为了把这条射线输入进 Transformer Decoder,论文使用了 Plücker 坐标 (Plücker coordinates) 来表示这条射线。
为什么需要射线
计算机屏幕或生成的图像是一个 2 D 的像素网格。渲染 3 D 场景的过程,本质上就是从相机中心出发,穿过屏幕上的每一个像素,向 3D 世界射出一条“射线 (Ray)”。这条射线在 3 D 空间中打到了什么物体,屏幕上的这个像素就是什么颜色。
目标相机的分辨率是 ,所以网络需要处理 条射线。
为什么传统的直线方程行不通
在几何里,表示一条 3 D 直线最直观的方法是:一个起点 加上一个方向向量 。直线上的任意一点可以写成:
但这在神经网络中有一个致命缺陷:表达不唯一。同一条直线,你可以选直线上的任意一点作为起点 。神经网络如果发现同样的输入对象对应了无数种不同的数值表达,它在学习时就会非常痛苦(无法收敛)。
普吕克坐标系
普吕克坐标系通过一种巧妙的叉乘,给 3 D 空间中的每一条直线提供了一个唯一、连续的 6 维向量表达。一条射线在普吕克坐标系下被表示为 :
-
方向向量 (Direction, ):这是一个 3 D 向量 ,表示射线的指向(通常会被归一化)。
-
力矩向量 (Moment, ):这是一个 3 D 向量 。它的计算公式是射线上的任意一点 与方向向量的叉乘:。
神奇的几何性质来了: 无论你在一条固定直线上选取哪一个点作为 ,它与方向向量 的叉乘结果 永远是同一个常数向量(因为叉乘的几何意义是以这两条边为基础的平行四边形的面积和法向量,对于同一条直线,这个“面积”和法线方向是恒定的)。
因此,网络通过接收 的普吕克特征(每个像素 6 个数字),就能确切、唯一地知道目标视角的每一根视线在 3 D 空间里是沿着什么轨迹穿梭的。这也是 LagerNVS 的 Decoder 最核心的输入。
参考视角
论文中明确指出,所有的相机参数 都是相对于第一台相机 来表达的。
-
网络会把第一张源图像拍摄时的位置和朝向,强行定义为这个 3 D 世界的绝对原点 和初始零旋转。
-
之后输入的第 2 张、第 3 张源图像相机,以及想求的目标相机 ,它们的平移 和旋转 ,描述的全部都是距离第一台相机有多远、偏转了多少度。这要分两种情况看:是在“训练模型(做题)”时,还是在“实际应用(考试)”时。
宏观架构设计
研究动机
在 NVS 领域,一直存在两个流派的相互博弈,而 LagerNVS 试图结合两者的优点:
-
传统显式 3D 重建(如 NeRF、3DGS): 效果极其惊艳,但痛点在于“慢”和“过拟合”。给你一个新场景,你需要花费几分钟甚至几个小时去专门为这一个场景进行梯度下降优化。它很难做到看一眼几张图,直接前向传播吐出新视角”。
-
纯神经网络直接生成(如 LVSM、SRT): 也就是端到端直接搞定。输入源图像,网络直接输出新图像,跳过 3 D 建模。速度极快,几毫秒搞定。但痛点在于,普通的神经网络(哪怕是强大的 Vision Transformer)缺乏“3D 空间想象力”,很容易把背面的、被遮挡的物体瞎画一通。
LagerNVS 的破局思路: 既然直接预测缺乏 3 D 想象力,那我不用普通的骨干网络提取特征。我用一个经过严格 3 D 监督训练过的网络(也就是论文里的 VGGT)来作为 Encoder 。这样提取出来的特征,虽然表面上是一堆一维的 Token,但它们体内流淌着“3 D 感知(3 D-aware)”的血液。
核心 pipeline
整个网络的运行流程非常清晰,可以分为三步:
-
特征提取 (Encoder): 将 张源图像(可能包含对应的相机外参)输入到 VGGT Encoder 中。这里不输出任何深度图或点云,仅仅从 Transformer 的最后一层截取输出的特征向量。
-
潜空间几何 (3D-aware Latent Tokens): 这就是这篇论文题目中的 “Latent Geometry”。Encoder 输出的特征被称为 。对于每张图像,网络提取出 个 Tokens(特征向量)。这些 Tokens 被打包在一起,作为整个 3D 场景的“隐式知识库”。
-
渲染生成 (Decoder): 将目标相机转化为射线 Tokens,把场景的 Latent Tokens 提取出来。通过 Transformer Decoder 的双向注意力机制进行信息检索,最终将特征重塑并投射成一张 的新视角 RGB 图像。
架构对比
在设计处理多张输入图像的信息流时,不可避免地会遇到数据结构和信息瓶颈的权衡。论文重点对比了三种主流架构方案,并选择了 Highway Encoder-Decoder :
-
Decoder-only(纯解码器):
把所有的源图像特征和目标相机射线一股脑全塞进一个巨大的 Transformer 里进行注意力计算。
- 致命缺点: 冗余计算太严重。每次你要生成新视角(哪怕场景没变,只是相机挪了一厘米),整个庞大的网络都要重新跑一遍。
-
Bottleneck Encoder-Decoder(瓶颈架构): 为了加快速度,把特征提取(Encoder)和渲染(Decoder)分开。但是,无论输入 2 张还是 10 张源图像,Encoder 都会强制把特征压缩成固定数量的 Tokens(比如定死只有 256 个 Tokens)喂给 Decoder 。
- 致命缺点: 发生了严重的信息丢失(Information Loss)。输入的图像越多,反而越容易丢掉细节。
-
Highway Encoder-Decoder(LagerNVS 的最终选择): 打破瓶颈!输入 张图像,每张图提取 个 Tokens,那就把整整 个 Tokens 全部一股脑、无损地传给 Decoder。
- 优势: 既保留了 Encoder-Decoder 分离带来的“一次编码,无限次快速渲染”的速度优势,又最大化保留了多视图带来的极高频的图像细节信息。
编码器剖析
Patchify
因为 VGGT 是基于 Vision Transformer (ViT) 的,因此在进入 VGGT 之前,需要先将图像切分为 patch。
-
切分为 ptach:当源图像(比如分辨率被调整为 518 x 518 )输入网络时,第一件事就是把它切成固定大小的网格(比如 16 x 16 像素的方块)。
-
图像变 Token: 假设切出了 个方块。网络会使用一个线性投影层,把每一个包含像素的方块,直接映射成一个一维的特征向量。此时,一张图片就变成了 个初始 Tokens。
-
VGGT 提取特征: 接下来,这 个 Tokens 才会进入 VGGT 的 Embedder 和 Aggregator(也就是我们上一阶段说的那几十层 Transformer)。
-
维度不变的流动: Transformer 的神奇之处在于,无论经过多少层,Tokens 的数量 始终不变。网络只是在不断加深和丰富这 个 Tokens 内部的数值(通道维度)。
-
最终输出: 所以,当 LagerNVS 从 VGGT 的最后一层“截胡”时,它拿到的依然是 个 Tokens 。这 个特征向量完美对应了原图最初被切分出的 个物理位置。
可选相机参数
11 维向量
论文明确指出,当输入相机参数时,相机参数被参数化为一个 11 维的向量 。这 11 个数字完美勾勒了相机的全部物理状态:
-
(4 维) - 旋转 (Rotation): 使用单位四元数 (Unit Quaternion) 表示相机在 3 D 空间中的朝向(比如抬头、低头、偏转)。
-
(3 维) - 平移 (Translation):相机在 3 D 空间中的具体 坐标位置。
-
(2 维) - 内参视场角 (Field of View):分别代表相机的水平(Horizontal)和垂直(Vertical)视场角大小,决定了镜头是广角还是长焦。
-
(2 维) - 场景尺度 (Scene Scale):也就是我们在第一阶段提到的,为了解决尺度模糊问题而引入的辅助参数。由于存在两种不同的尺度归一化方式(一种基于相机最大平移距离,一种基于观测到的 3D 点平均距离),所以使用了 2 维来表示这两个维度的尺度因子。
输入网络
Transformer 只能看懂高维的 Token,看不懂这区区 11 个孤零零的数字。所以论文做了一个很工程化的处理:
-
升维投影: 论文给 VGGT 加了一个小型的MLP(具体是两层线性层中间加一个 SiLU 激活函数)。这个 MLP 把 11 维的物理向量,强行投射成了一个 1024 维的特征 Token 。
-
融合进网络: VGGT 原本就有一个专门占位的“相机 Token”的初始值。这个升维后的 1024 维向量,会直接与原始的相机 Token 相加,然后和那 个图像 Tokens 一起送进 VGGT 网络里“炼丹” 。
可选
如果在实际应用中,你真的没有相机参数(比如就是随手在网上下载的几张照片),网络依然能工作: 代码逻辑会极其简单粗暴地把这 11 维向量的前 9 维(也就是 )全部设为 0(只保留尺度的归一化因子)。网络在训练时见过了大量这种“缺失相机信息”的数据,所以即使输入是 0,它的注意力机制也能强行通过对比图像内容来脑补出大概的 3D 结构。
VGGT
VGGT 本身是另一篇顶会论文提出的模型。它的原始设计目标就是:输入几张图,直接前向传播输出每张图的深度图和相机姿态等 3D 几何信息。
为了做到这一点,VGGT 的架构并不是普通的 Transformer,而是分为了两个非常特别的阶段 :
图像嵌入器 (Embedder)
这是一个 24 层的 Transformer 。
- 作用: 独立看世界。它把输入的 张照片当作完全不相关的图片,一张一张地提取特征。这个阶段,网络只是在理解“这儿有棵树”、“那儿有扇窗”,还没建立 3D 联系。
聚合器 (Aggregator)
这是一个 48 层的 Transformer,它的内部设计非常精妙,交替使用两种注意力机制 :
-
局部注意力 (Local Attention): 只在单张图片内部寻找特征之间的联系。
-
全局注意力 (Global Attention): 打破图片的界限!让图 1 的某个特征去和图 2、图 3 的特征进行匹配和对比。
-
这种交替计算,本质上就是在做传统多视图几何里的特征匹配和立体视觉匹配 。网络在这个阶段学会了:“图 1 左边这个角,对应图 2 右边那个角,所以这个物体应该是凸出来的”。
LagerNVS 中使用
LagerNVS 并没有使用 VGGT 最终输出的深度图或相机数据。它就像是一个半路打劫的黑客,直接在 VGGT 的网络深层“截胡”: 它把 VGGT 最后一层局部注意力和最后一层全局注意力的输出向量直接拿了出来,把它们拼接在一起。这些截胡出来的 Tokens,就是蕴含了 3D 几何先验知识的 Latent Tokens。
解码器剖析
LagerNVS 的 Decoder 本质上是一个包含 12 层块(Blocks)的 Vision Transformer (ViT-B)。我们把这个过程拆解为三个步骤。
射线 token 化
目标视角的来源
这要分训练阶段和推理阶段考虑。
训练阶段
论文用的训练集(比如 RealEstate 10 k)其实是一段段的视频。
假设视频有 100 帧。训练时,我们可能随机挑第 1、5 帧作为源图像(输入给 Encoder),然后挑第 3 帧作为目标图像(用来算 Loss)。
在这个阶段,目标相机 的姿态是数据集自带的。现有的图形学算法(SfM,比如 COLMAP)早就把视频里每一帧相机的相对位置算得清清楚楚了。我们只是把第 3 帧的实际相机参数拿过来,作为目标视角喂给 Decoder,然后看它生成的图跟第 3 帧的真实照片像不像。
推理阶段
此时,目标视角 是完全由用户决定的。
-
当用鼠标在屏幕上拖拽(就像玩 3D 游戏那样转动视角),或者按键盘上的 W/A/S/D 前进后退时,前端程序会把你鼠标或键盘的移动,实时换算成一个包含旋转和平移的 11 维向量 。
-
每动一下鼠标,程序就生成一个新的 喂给 Decoder。因为 Decoder 跑得极快(30 FPS+),所以看到的就是一个实时渲染的、可以在里面漫游的 3D 场景。
目标视角计算为射线
这就是经典的计算机图形学光线投射(Ray Casting)过程:
-
创建虚拟屏幕: 首先,根据目标相机的分辨率生成一个 的 2 D 像素网格。
-
像素转局部射线(用内参 ):根据相机的视场角 (决定了视锥体的张角),计算出每一条射线穿过像素点时,在相机自己的局部坐标系里的方向。比如屏幕正中心的像素,它的局部射线方向就是直直向前的 。
-
局部射线转世界射线(用外参 ):这一步最关键。刚才的射线只是在相机自己眼里的方向,我们需要把它放到以“相机 1”为中心的“世界”里。
-
用目标相机的平移 ,确定这根射线在世界里的起点。
-
用目标相机的旋转 ,对刚才的局部射线方向进行旋转,得到它在世界里的绝对方向。
-
-
转化为普吕克坐标: 现在我们有了射线的世界起点 和世界方向 。按照公式 ,算出每条射线的方向 和力矩 。
-
拼装送入网络: 把所有射线的 拼在一起,送给Transformer Decoder 进行计算。
目标视角 token 化
解码器拿到的目标相机特征是一个形状为 的张量,需要把这个张量转化为一维的 Token 序列。
-
卷积降维压缩: 论文使用了一个步长为 8 的卷积核(Stride = 8)。这意味着它把每 的一束射线打包成了一个 Patch。这样一来,Token 的数量就大幅减少到了 个。
-
加入寄存器 (Register Tokens): 论文额外拼凑了 4 个特殊的“寄存器 Token”进去(这是一种近年在 ViT 中很流行的技巧,用来存放一些全局的、不需要和特定空间绑定的冗余信息,防止注意力机制乱套)。
我们将这 个代表目标相机射线的 Tokens 统称为集合 。
寄存器 (Register Tokens) 在使用 Vision Transformer (ViT) 处理图像时,研究人员发现了一个奇怪的现象: Transformer 在处理图像时,偶尔需要汇总一些全局信息(比如“这张图整体偏暗”、“这是一个室内的场景”)。但是,原版的 ViT 里只有对应着图像物理位置的 Patch Tokens。 于是,网络会强行征用画面中那些最没有信息量、最平坦的背景区域(比如纯蓝的天空、纯白的墙壁)对应的 Tokens,把它们当成“全局信息存储罐”。这导致在可视化注意力地图(Attention Map)时,背景区域会莫名其妙地出现极其强烈的亮点(被称为 Attention Sinks),这会干扰模型对真正重要特征的提取。 既然网络需要地方存全局信息,强行占用背景特征又会引发混乱,那怎么办? 《Vision Transformers Need Registers》提出:直接给网络输入几个空白向量。
- 具体做法是:在输入序列的末尾,人为地拼接几个毫无物理意义的、全凭网络自由学习的空白向量(这就是 Register Tokens)。
- 这样一来,Transformer 在做自注意力计算时,就会乖乖地把那些全局的、不需要和特定空间绑定的特征信息,存放到这些寄存器里。原本的图像特征 Tokens 就能被解放出来,专心致志地处理纯粹的局部视觉信息。
双向交叉注意力机制
现在有两种输入:
-
(Target Camera Tokens): 计算得到的目标射线,它们是带着疑问来的(“我这条线上应该是什么颜色?”)。
-
(Source Latent Tokens): 从 VGGT 编码器拿到的 个带有 3D 感知信息的源图像特征(知识库)。
论文测试了两种注意力机制。
全注意力 (Full Attention)
把目标射线 和源特征 全部拼接成一个超长的序列,然后做标准的自注意力计算:
-
物理意义: 所有人都在互相交流。射线在寻找特征,特征在互相印证,射线之间也在对齐。
-
致命缺陷: Transformer 的计算复杂度是输入序列长度的平方。源图像数量 越多,序列越长,计算量呈 爆炸式增长。论文指出,这种方式最多只能支持 6 张输入图片保持 30 FPS 的实时渲染。
双向交叉注意力 (Bidirectional Cross-Attention)
为了提速,作者巧妙地修改了信息流动的方向(详见论文附录的 Alg 1),将其拆分为两步并行的交叉注意力:
-
射线询问特征: 射线的 Token 作为 Query (),源特征 作为 Key 和 Value ()。
物理意义: 射线精准地去源图像的特征库里检索自己穿过了什么物体、提取对应的颜色和几何信息。
-
特征感知射线:源特征 作为 Query (),射线的 Token 作为 Key 和 Value ()。
物理意义: 3 D 知识库也会根据当前目标相机看的位置,动态调整自己的状态,把最重要的信息“推”给射线。
- 为什么这么快? 因为在这个方案中,源特征 内部不再互相计算自注意力了!那些成千上万的 个特征,在 Decoder 阶段只负责和目标射线交流。这把复杂度从 硬生生降到了 ,使得模型可以在输入 9 张高清源图像时,依然保持 30 FPS+ 的实时运行速度。
渲染输出
经过 12 层 Transformer 块的层层淬炼,射线 Tokens 已经完全吸收了它们需要的信息。
最后一步非常干脆:
-
把源特征 Tokens 和那 4 个辅助用的寄存器 Tokens 直接丢弃,只留下射线 Tokens。
-
把这些一维的射线 Tokens,通过一个简单的线性层,投影回 的 RGB 像素块。
-
把所有像素块按照原来的空间位置拼接回去,再套一个 Sigmoid 激活函数(确保颜色值在 0~1 之间),一张目标视角的全新图像 就输出了。
训练、优化与扩散模型扩展
确定性回归训练
损失函数
在训练阶段,LagerNVS 是一个纯粹的有监督回归模型。它的目标是让预测出的新视角图像,尽可能逼近真实拍摄的那张照片(Ground Truth)。
论文使用了一个非常经典的混合损失函数 :
-
(均方误差 MSE): 这是最基础的像素级对比。算一下预测像素和真实像素的颜色差值的平方和。
- 痛点: 纯用 MSE 会导致画面极其模糊。因为当网络“不确定”某个细节时(比如草地的纹理),为了让惩罚最小,它会干脆输出所有可能颜色的“平均值”。
-
(感知损失 LPIPS): 为了对抗模糊,引入了感知损失。它不是比对像素,而是把生成的图和真实图同时扔进一个预训练的图像分类网络(比如 VGG)里,比对它们在深层提取出来的“特征图”差异。这能逼迫网络生成更锐利、更符合人类视觉直觉的高频细节。
端到端微调
虽然 Encoder 是直接拿别人训练好的 VGGT 初始化的,但论文强调,必须把整个网络解冻,端到端一起训练。因为 VGGT 以前只关心“几何”(哪儿深哪儿浅),完全不关心“外观”(比如透明度、高光反射)。如果不微调,生成的画面就会像石膏模型一样缺乏真实的质感。
的处理
在训练时,针对每一个场景,网络理论上既能算出 ,也能算出 。但是作者引入了随机掩码机制 :
-
有 1/3 的概率,把 强行设为 0,只给 (模拟单视角或原地旋转的情况)。
-
有 1/3 的概率,把 强行设为 0,只给 (模拟常规多视角输入)。
-
有 1/3 的概率,两个都给。
结果: 经过这种严苛的训练,Transformer 网络被迫变成了一个极具鲁棒性的系统。在推理阶段:
-
如果你给它好几张照片,它会自动提取 ,忽略 。
-
如果你只给它一张照片,算出 设为 1.0,把 设为 0 输入进去。网络一看 是 0,立刻心领神会:“哦,这是单图模式,我要根据平均深度来推算移动距离。”
确定性模型的问题
LagerNVS 的主体是一个确定性的模型:给固定的输入,永远吐出固定的输出。这就带来了一个致命的问题:遇到完全看不见的区域怎么办?
-
场景重现: 假设源图像只拍到了一个沙发的正面。然后你让目标相机强行走到沙发背面去看。
-
网络的挣扎: 网络翻遍了源图像的 个特征,发现根本没有沙发背面的任何线索。但 MSE Loss 拿着鞭子逼它必须画点什么。
-
惨烈后果: 网络只能硬着头皮“猜”。为了稳妥,它猜了一个最不容易出错的“模糊色块”(比如灰棕色的糊糊)。这就是所谓的“向均值回归(Regression to the Mean)” 。在遇到复杂的遮挡(Occlusion)和外推(Extrapolation)时,普通的 LagerNVS 会显得非常无力。
扩散模型扩展
既然普通的 Decoder 只能给出一个确定的死板答案,那我就把它变成一个生成模型,让它能够在面对未知区域时,根据学过的先验知识,合理地“幻觉 (Hallucinate)”出细节。
模型改造
-
冻结解码器: 把 VGGT Encoder 完全冻结住。因为提取 3D-aware Latent Tokens 这项工作它已经做得很完美了。
-
输入加噪:
- 原本 Decoder 的输入(Patch Embedding 层)只接收 6 个通道的信息(就是 的目标相机普吕克射线)。
- 改造后,强行给输入层增加了 3 个通道,用来接收被加了高斯噪声的 RGB 图像。
- 也就是说,现在的 Decoder 一次性接收 9 个通道 ()的输入:射线告诉它“你看向哪里”,噪声图像告诉它“你要去噪的底稿是什么” 。
-
时间步注入: 引入大模型中常用的
adaLN-zero层,把去噪时间步(Timestep )作为条件注入给 Decoder 的每一层。
去噪训练
在训练这个改造后的 Diffusion Decoder 时,作者采用了一套非常扎实且偏向于高分辨率图像生成的策略:
-
像素空间,拒绝潜空间: 不同于 Stable Diffusion 这种把图片压缩到 Latent 空间去去噪的模型,LagerNVS 是极其直接地在像素空间进行去噪操作的。
-
直接预测干净图像 ( Prediction):大部分扩散模型是训练网络去预测“噪声()”,然后用原图减去噪声。但 LagerNVS 训练模型直接预测那张完全干净的图像(即 )。这在基于 Transformer 的扩散模型中能带来更好的细节表现。
-
DDIM 调度与高分辨率适配:
-
使用了 DDIM 调度器,设置了 1000 个训练时间步(Timesteps)。
-
调度是线性的,从 到 。
-
硬核 Trick: 为了适应相对较高的分辨率(),他们使用了一个带位移(shifted with a ratio of 4)的 Zero-SNR 噪声调度器。这也是目前高分辨率扩散模型常用来防止画面灰暗发白的关键技术。
-
-
损失函数配置: 在微调时,作者依然使用了组合拳,但权重有所调整:均方误差的权重为 1.0,感知损失的权重高达 4.0 。学习率设为很保守的 ,仅仅微调了 6 万步就收敛了。
局限性
伪影与视频闪烁
这是隐式/神经渲染领域最臭名昭著的问题。
-
模糊与块状伪影: LagerNVS 的主体是一个确定性模型。当面对未观测到的区域(比如物体的背面),如果强行用确定性回归模型去推断,它无法生成高质量的“幻觉(Hallucination)”,只会吐出带有块状伪影的模糊画面。
-
视频漫游的灾难: 很多 NVS 系统的最终目的是生成一段平滑的漫游视频。但如果用 LagerNVS 渲染视频,你会发现画面会产生严重的闪烁感 。这种闪烁来自于网络对几何估计的不确定性、对未观测区域的瞎猜,以及源相机姿态本身可能估计得不准。
-
Diffusion 的尴尬: 虽然作者引入了 Diffusion 模型来解决模糊和遮挡问题,但论文明确指出,这个 Diffusion 解码器只能生成独立的单张图片。如果你连续生成两帧视频,Diffusion 在面对缺失信息时,第一帧可能“脑补”出了一个红色的条纹,第二帧可能“脑补”成了蓝色的波点。帧与帧之间毫无时序一致性,如果强行连成视频,画面会像霓虹灯一样狂闪。
高频细节缺失
LagerNVS 在渲染大面积的平滑表面(如墙壁、天空、桌面)时效果极佳,但论文承认,遇到像草地或树叶这种具有大量高频细节的区域时,它的表现会系统性地变得非常糟糕。
-
背后的计算机科学原理:图像被 VGGT 提取成了 个 Tokens。这相当于把巨大的像素信息压缩到了一个极小的潜空间里。对于极其细碎、混乱且密集的草地纹理,这有限的 个特征向量根本“记不住”这么复杂的细节。
-
显式 3 D 的反击: 相比之下,这恰恰是 3D Gaussian Splatting (3DGS) 这类显式表征的绝对主场。3DGS 可以简单粗暴地在草地上撒几百万个带有颜色的小高斯球,轻松还原每一根草的细节,而不用强行压缩成一维 Token。
理想化数据假设
深度学习模型永远受限于它的训练数据分布。LagerNVS 的训练集高度理想化:
-
拒绝动态: 它的训练数据全是纯静态的场景,甚至连人类都没有包含在内。如果源图像里有一个正在走路的人,或者随风飘动的窗帘,VGGT 提取的 3D 几何特征会直接崩溃,因为它根本不理解什么是“运动”。它会把人当成一个奇怪的、被拉扯变形的静态雕像。
-
拒绝镜头畸变: 论文使用的是完美的针孔相机模型(11 维参数)。训练数据中没有包含鱼眼镜头(Fish-eye)等带有严重畸变的图像。如果在真实场景中用 GoPro 或安防监控器拍的图喂给它,射线的计算会完全偏离实际的物理轨迹,导致渲染出来的图像严重错位。
个人思考
对于使用扩散模型来渲染视频时,为了保证时序一致性,可以把第一帧作为第二帧的参考图像,当然这会导致计算量增加且需要重新跑编码器。这可能需要图像一致性的相关研究,对解码器进行一定的修改。
论文中使用的扩散模型解码器,看起来并不是很正宗的样子,无潜空间且直接预测图像,或许使用目前广泛使用的比如 FLUX 效果会更好?比如我也复刻一个 FLUX,用成熟的 FLUX 来初始化我的参数,我再额外注入视角信息来微调。
对于高频细节丢失,中先进的图像生成模型哪怕是通过 VAE 压缩又 PATCH 化,高频细节也很好。所以这个解码器如果使用先进的扩散模型的话,或许效果会好一些。
论文原文